一个编码任务里,难题和例行步骤经常交替出现:定位故障要仔细推理,读文件、执行明确修改、处理普通工具结果,未必需要同一档模型。
上一版 Jev Auto Router 的直觉是:既然每次模型调用都不同,那就让 Jev 在每一次调用前重新选一次模型。
这个设计能跑,但忽略了一个很贵的现实:切模型会让新模型重建 prompt prefix。 在长会话里,重建成本可能比“选对更便宜的模型”省下来的钱还多。
第二版把决策粒度从 Model Call 提到了 Turn:
一个 user turn 只问一次 Jev,模型固定到这一轮的整个 tool loop;effort 可以单独调整。
这篇文章记录新的 turn-pinned 架构、effort routing 的边界,以及我对“什么时候真的省钱”的判断。
当前状态: 0.1.0 alpha。确定性测试 63/63 通过;真实 Codex + GPT 的 cache 命中和质量非劣还没有完成端到端验证。effort routing 默认关闭,先做小任务 smoke,再考虑长期开启。
先把三个词说清
Session
└─ Turn:你发一句话 → 最终回答
   ├─ Model Call 1
   ├─ Tool Call / Tool Result
   ├─ Model Call 2
   └─ ...
- Model Call:模型被请求一次。工具结果回来后再次请求,就是新的 Model Call。
- Tool Loop:模型 → 工具 → 模型 的来回。
- Turn:你发一句话,到它最后答完。
旧设计在每次 Model Call 前都路由;新设计只在新的 user turn 开头路由。tool continuation、工具结果回传、同一轮的重试,都复用已经固定的模型。
逐调用路由为什么不对
Prompt cache 按请求前缀命中。前缀包括 system/developer 消息、工具定义、历史消息等。
切到另一个模型时,新模型需要重新 prefill 这个前缀;旧模型已经建好的 cache 不会自动共享给新模型。上下文越长,这笔重建越贵。
更糟的是 tool loop:
- 一次工具调用后,模型要重新读一遍前文;
- 如果每次都重新选模型,就可能每次都触发一次 prefix 重建;
- 任务中途模型还会来回摇,行为不稳定。
所以 turn-pinned 的原则不是“少选几次模型”这么简单,而是:
把切换限制在 turn 边界,让 tool loop 内部只发生模型调用,不发生模型切换。
这也是第一张图想表达的主线。
主流程:一个 Turn 只做一次决定
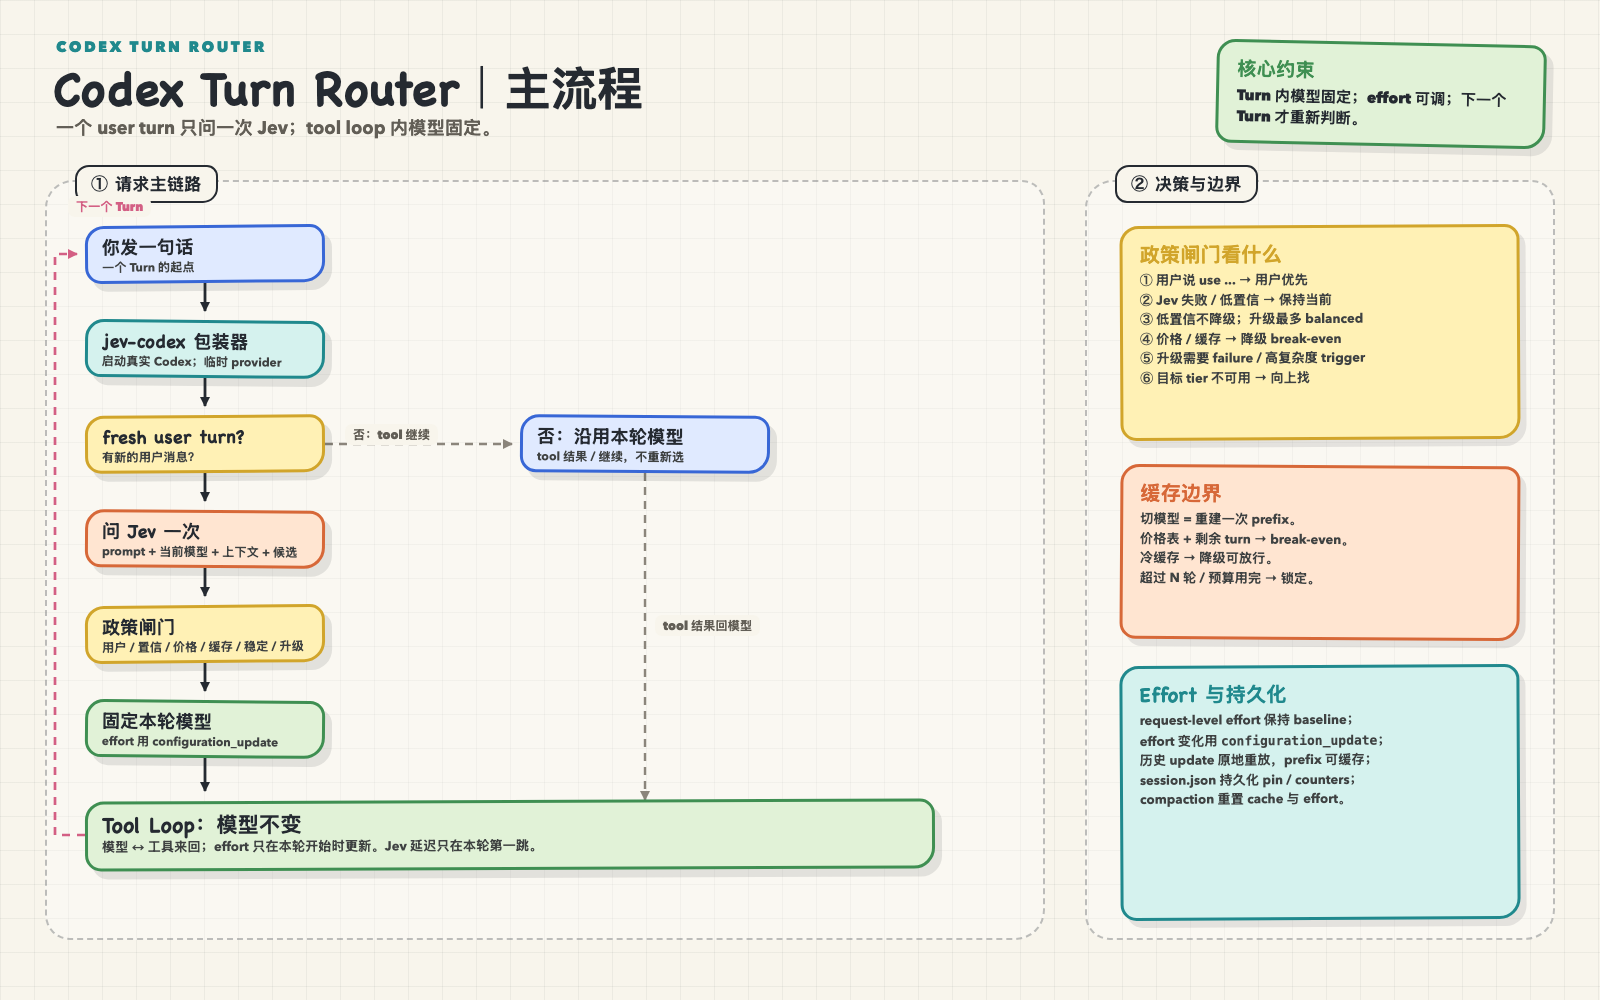
一次 turn 的路径:
- 你发一句话,
jev-codex启动真实 Codex,并把虚拟模型jev-auto放进 picker。 - 本地代理识别出这是一个 fresh user turn。
- 把 prompt、当前模型、上下文和候选模型交给 Jev,问一次。
- Jev 返回模型选择、置信度和复杂度评分。
- 确定性 Guard 检查用户指定、置信度、可用性、价格、缓存和稳定保护。
- 把选中的真实模型写进请求;这一轮后续的 tool loop 全部复用它。
- 下一次 user turn 才重新判断。
几个容易被忽略的细节:
- Jev 只在新 turn 被问一次,不是每次 model call 都问。
- 相同请求重试不重复问 Jev:prompt hash 和上下文长度相同,就复用上一轮决策,避免 transport retry 触发第二次选择。
- 手动选真实模型会绕过路由:
jev-auto只在 picker 里出现,用户显式选择gpt-6-sol之类的真实模型时直接透传。 - 工具执行仍然由 Codex 管理:Jev 只做一次结构化选择,不接管工具,也不成为执行模型。
模型固定之后,effort 才是细粒度变量
模型固定下来后,还有一个变量可以动:reasoning effort。
这就是第二张图里的控制回路:选 → 闸 → 跑 → 学。
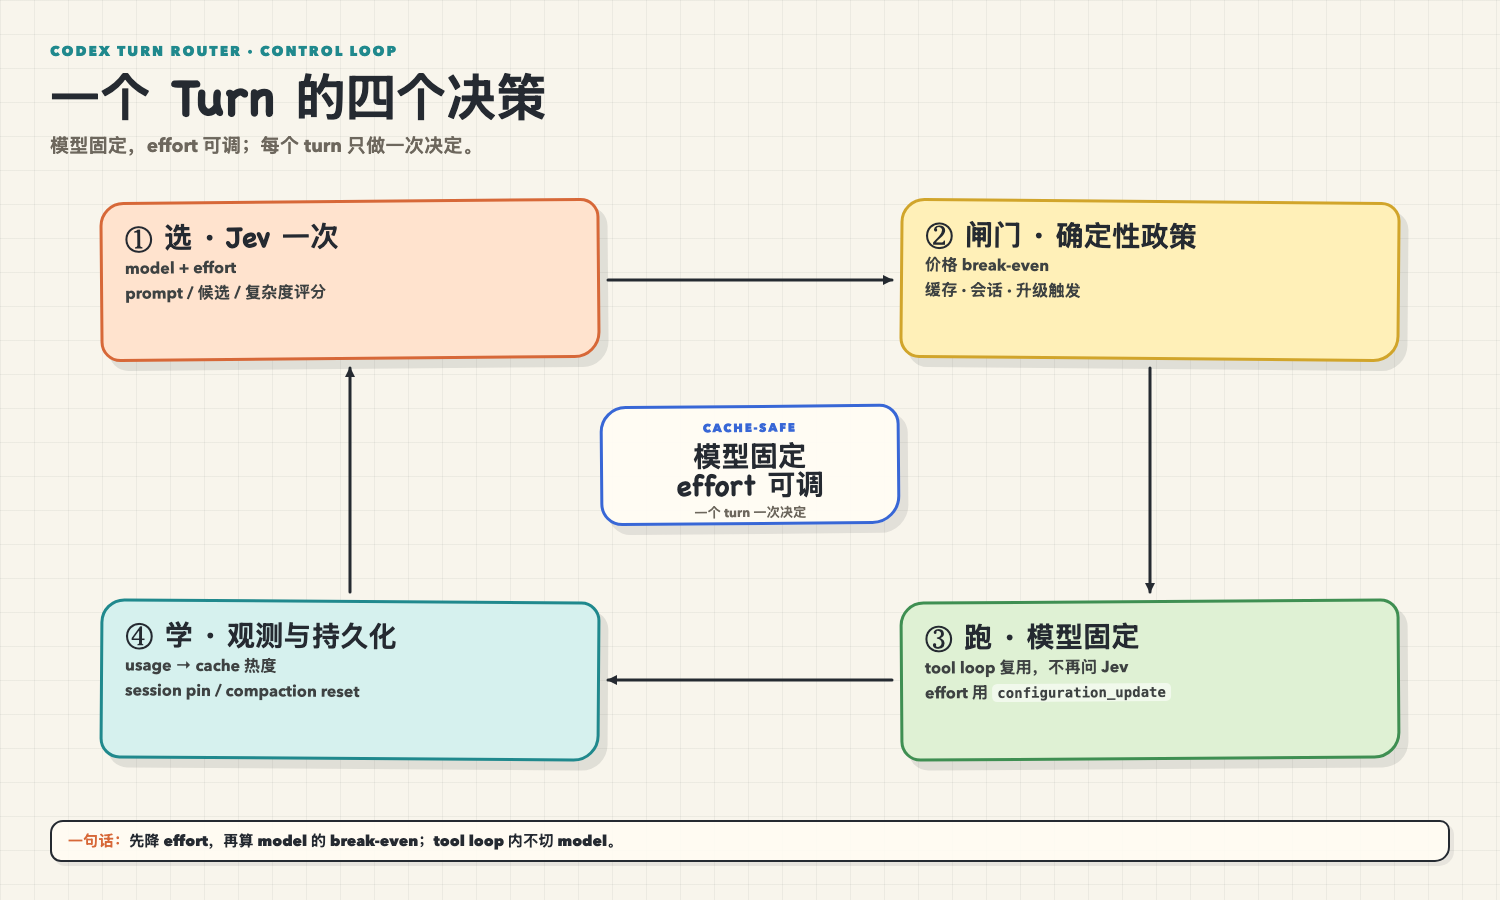
关键区别可以压成一张表:
| 变量 | 改什么 | 对 cache 的影响 |
|---|---|---|
| Model | 单价、能力、上下文窗口 | 新模型要重建 prefix |
| Effort | reasoning / output token | 模型和 prefix 不变,可以保留 cache |
| Session pin | 模型稳定、切换次数、冷却 | 不改变请求前缀 |
所以更合理的顺序是:
先降 effort
再在 break-even 过线时降 model
永远不要在 tool loop 内切 model
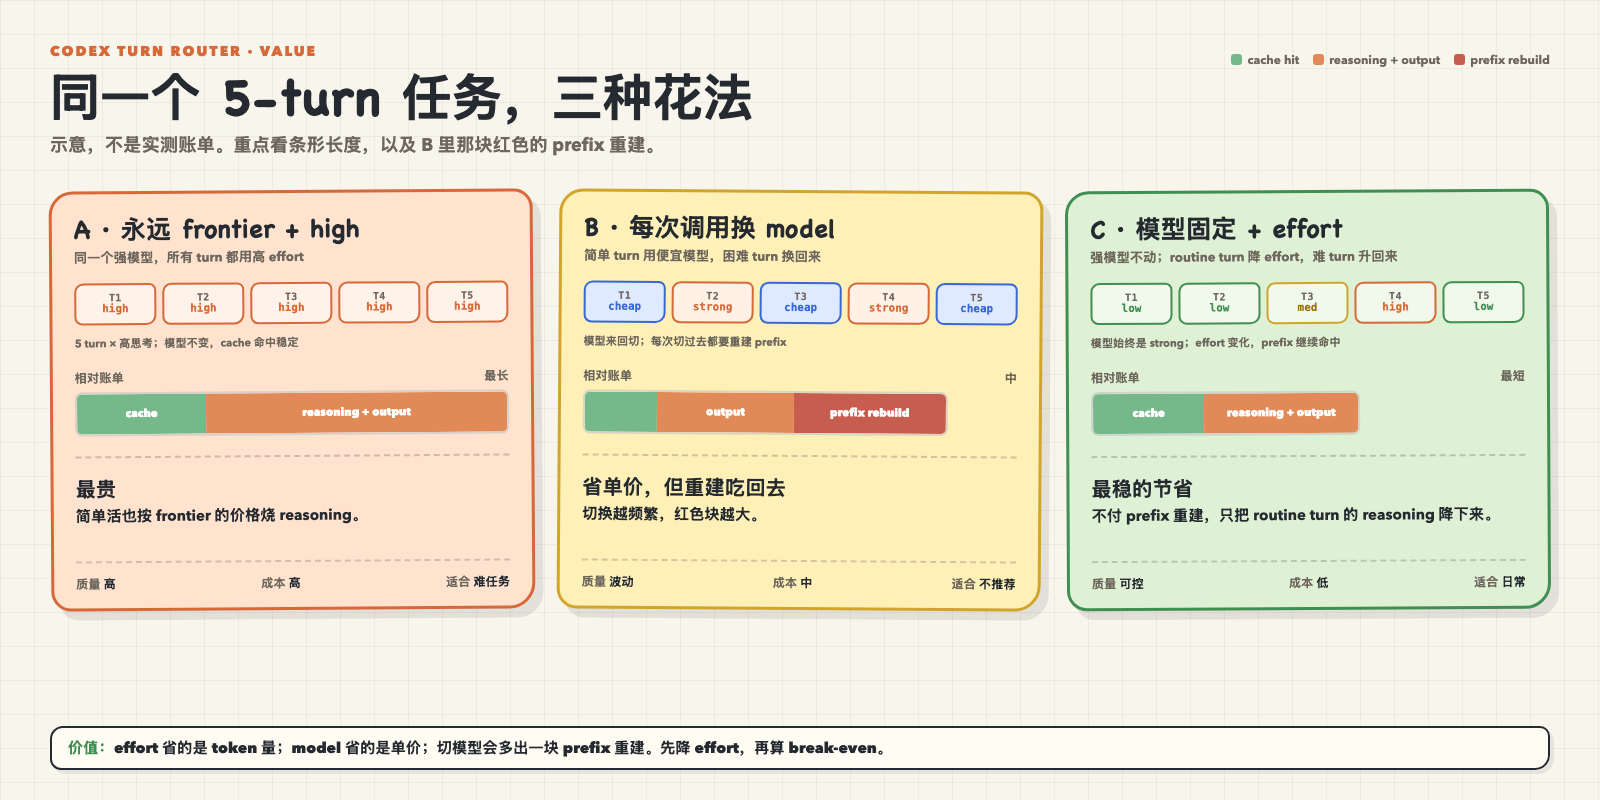
effort 怎么改,才不会把 cache 弄丢
在支持 mid-conversation effort update 的模型上,做法不是改请求顶层的 reasoning.effort,而是:
- request-level effort 保持 baseline 不变;
- 需要变化时,在历史里插入
configuration_update; - 后续请求把之前的 update 按原 anchor 重放,保持 prefix 连续;
- compaction 或模型切换时,重置 baseline 和 update;
- 用
JEV_CODEX_EFFORT_CAP限制上限,默认high; - 没有评分时回退到
JEV_CODEX_EFFORT_FALLBACK。
当前实现是 per-turn effort,不是 per-step。也就是说,一个 turn 开始时选一次 effort,tool loop 内沿用;还没有做到“读文件用 low、连续失败升 high”的逐步骤调节。
这不是偷懒,而是因为 per-step 需要更完整的 history provenance:一个薄代理如果只是在每次请求末尾追加 update,却不在下一轮保留旧 update,prefix 会立刻分叉,反而更贵。
因此第二版先把 per-turn 做对,并把 effort routing 默认设为关闭:
export JEV_CODEX_EFFORT_ROUTING=turn
先跑一个小任务 smoke,确认 provider 接受 configuration_update,再长期开启。
关键分析:收益到底从哪里来
先说结论:
最大的浪费通常是“贵模型 + 高 effort 做简单活”,但真正能安全收割的通常是 effort,不是 model。
原因是两者的成本结构不同:
- 降 model:所有 token 的单价都降,但新模型要重建 prefix;长上下文下,重建可能吃掉好几轮节省。
- 降 effort:模型和 prefix 都不变,减少的是 reasoning 和 output token;这部分本来就不在 cache 里。
- per-call 切 model:一个 tool loop 内反复重建,通常是最差的选择。
竞品的数据也能说明“收益取决于 baseline”:
- dominicrico/jev-router 在 Claude Code 上的真实运行:小任务相对 always Opus −97%,日常任务 −65%;但困难任务上 plain Sonnet 最便宜。它的长 warm session 还有一个诚实的弱项:cache guard 把切换从 6 次降到 1 次、cache 重写减半,但账单没变,lean 平均 Opus 成本,plain Sonnet 还便宜 43%。
- robertn702/reasoning-router 的精选 SWE-bench 示例:短 Flask 修复输出 token −52%,较难的 Django/pytest 只有 −5~7%。这是 selected tasks,不是普遍保证。
- nanocode PR #805 证明了 cache-preserving effort update 的请求形态,但 PR 明确说测试是 synthetic,没有 live cache-hit claim。
这些数字不能直接搬到我们的项目上,但它们给出一个很重要的实验设计原则:
必须同时报告“相对 always frontier”和“相对已经用中间档模型”的收益。 否则很容易把“不要什么都用 Opus”说成“路由很聪明”。
确定性政策:Jev 提议,代码决定
Jev 只负责给判断,不直接改请求。真正决定是否切换的是本地 policy:
- 用户 override:
use ...永远优先; - 置信度:低置信不降级,升级最多到 balanced;
- 可用性:目标 tier 不在当前目录里就向上找;
- 价格 break-even:有价格表时,算重建成本 / 每 turn 节省,剩余 turn 不够就不切;
- 缓存热度:响应 usage 里的
cached_tokens为 0 时,当前模型是冷缓存,降级可以放行; - 稳定保护:超过 N 轮、切换预算用完、cooldown 未到,就锁定当前模型;
- 升级触发:默认只在上游 failure、高复杂度信号或用户指定时升级,避免 Jev 一说升级就切;
- compaction:上下文被压缩后,缓存和 effort provenance 一起重置。
价格 break-even 的核心就一行:
重建成本 / 每 turn 节省 ≈ 需要多少 turn 才回本
剩余 turn 小于这个数,就不值得切。没有价格表时,回退到固定的上下文阈值,不假装自己会算钱。
Session 状态会持久化到:
~/.codex-router/sessions.json
只存模型、tier、turn/switch 计数、缓存观测和 effort baseline,不存 prompt 或凭据。这样 codex resume 后不用从零重新判断,也能避免恢复会话时又切一次模型。
现在证明了什么,没证明什么
已经证明的是确定性的部分:
- turn 识别、tool continuation 不重复问 Jev;
- 相同请求重试不重复路由;
- 模型在 tool loop 内不变;
- 价格 break-even、冷缓存、升级触发、session lock/cooldown 的 gate 行为;
- effort anchor 的插入、重放、失效和 compaction 重置;
- session store 的加载、保存和 TTL。
还没有证明的是商业上最重要的问题:
- 真实 GPT 模型上的 cache 命中率;
- effort 降低后质量是否非劣;
- 真实 output/reasoning token 节省;
- 端到端延迟和 Jev 成本;
- 长 warm session 里到底能不能回本。
评测计划在仓库的 evaluation-plan.md:6 个合成任务 × 3 个 arm(always strong/high、effort-only、model+effort)× 3 次,再加 20 个真实任务。成本要算全:input、cached、cache write、output、reasoning、Jev、重试和验收。质量先于成本,低质量低价不算节省。
上手试试
当前是源码安装;npm 包 0.1.0 还在准备发布。
git clone https://github.com/miniLV/Jev-Auto-Router.git
cd Jev-Auto-Router
npm ci
npm run build

export JEV_API_KEY="<your-typesafe-key>"
node bin/jev-codex.mjs
effort routing 默认关闭。想试新的控制回路:
export JEV_CODEX_EFFORT_ROUTING=turn
export JEV_CODEX_EFFORT_CAP=high
node bin/jev-codex.mjs
然后在 Codex 的模型选择器里选 jev-auto。想绕过路由时,直接选真实模型即可。
更完整的配置、价格表和 session 选项见 README 和 设计文档。
还缺什么
- per-turn effort 已落地,per-step effort 还没做;
- 只对声明
supports_reasoning_effort_updates的模型启用; - cache warmth 只观测当前模型,还没有 per-target cache 记录;
- 升级触发还没有解析工具错误和验收失败;
- session store 没有跨进程写锁;
- 真实 Codex + GPT 的 live smoke 和配对评测还没完成。
所以它现在是一个能工作的 alpha,不是“已经证明省钱”的成品。
写在最后
第二版最重要的变化,不是多了一个 effort 参数,而是承认了一件事:
路由的价值不只是“选更强的模型”,也包括“少做几次昂贵的切换”。
模型是粗粒度变量,effort 是细粒度变量。先降 effort,再算 model 的 break-even;不要在 tool loop 里反复切模型。
这比“每次调用都让 Jev 选一次”更慢一点,但更稳、更便宜,也更像真实编码任务的工作方式。
源码:miniLV/Jev-Auto-Router(Apache-2.0)
设计文档:docs/codex-turn-router.md
评测计划:docs/evaluation-plan.md